


软件

产品


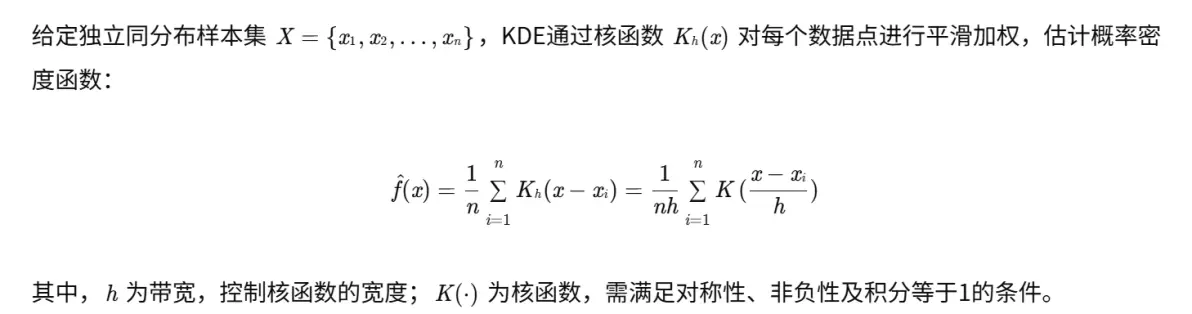
核密度估计(Kernel Density Estimation, KDE)作为一种非参数统计方法,通过“平滑”离散数据点来估计概率密度函数,无需预设分布形式即可适应复杂数据分布。在数据生成领域,KDE凭借其非参数特性、数据特征保留能力和可解释性,在数据增强、异常检测、隐私保护等场景中展现出独特优势。然而,带宽选择、高维数据“维度灾难”及计算效率等问题仍制约其应用范围。本文系统梳理KDE数据生成方法的原理、流程、优势与挑战,结合实际应用案例探讨改进方向,为数据驱动的研究提供理论参考与实践指导。
编辑
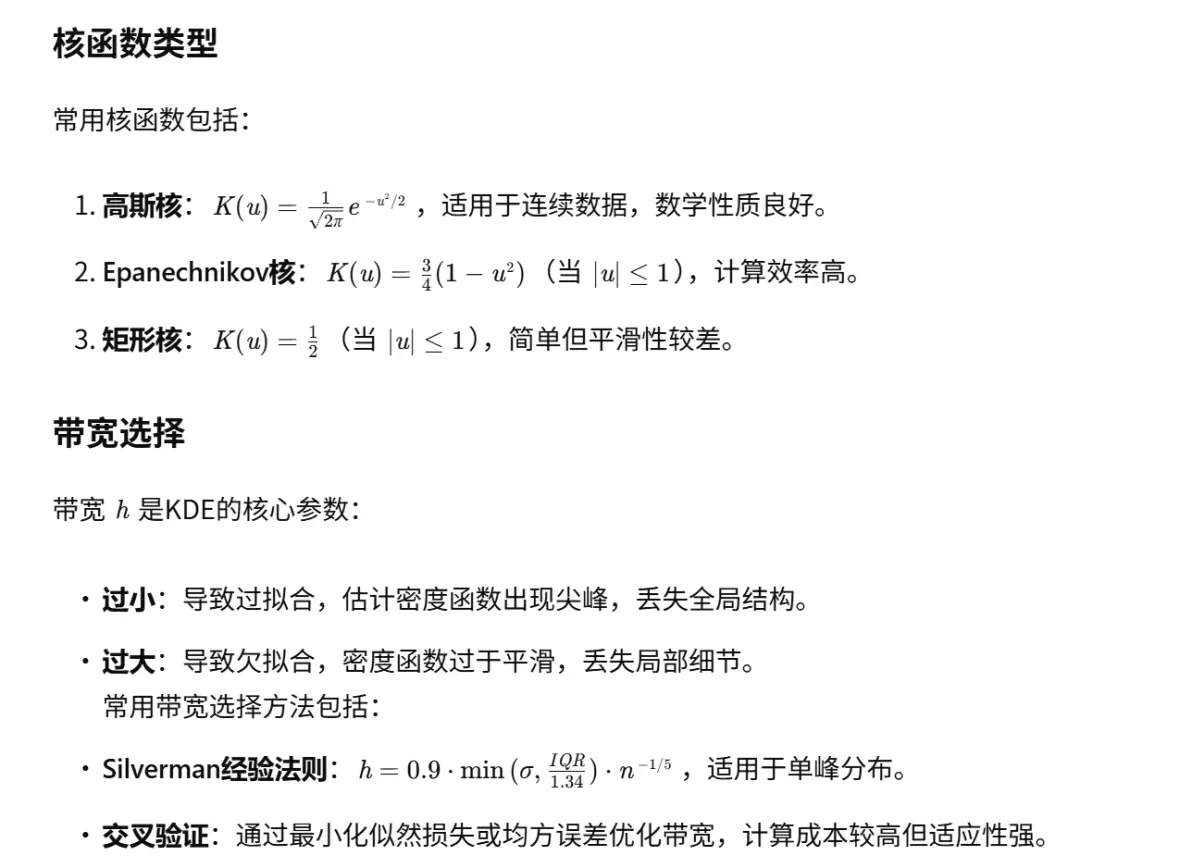
场景:手写数字识别任务中,原始数据集样本量不足,导致模型泛化能力差。 方法:
场景:模拟股票价格波动,评估风险模型性能。 方法:
场景:医疗数据共享需保护患者隐私。 方法:
基于KDE的数据生成方法凭借其非参数灵活性和数据特征保留能力,在数据增强、异常检测、隐私保护等领域具有重要应用价值。尽管面临带宽选择、高维计算等挑战,但通过自适应带宽优化、高维加速算法及与深度学习融合,KDE有望在数据科学和人工智能领域发挥更大作用。未来研究需进一步探索其在复杂数据结构(如流形、图)上的适用性,推动数据生成技术的智能化与高效化发展。
编辑
编辑
部分代码:
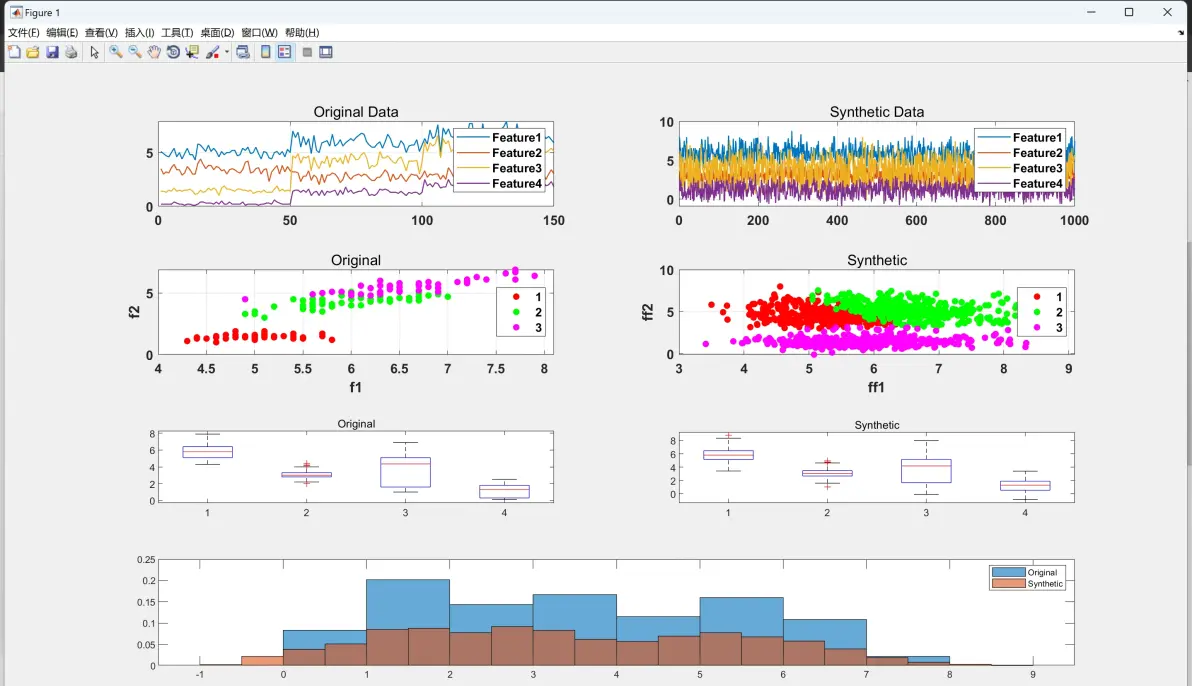
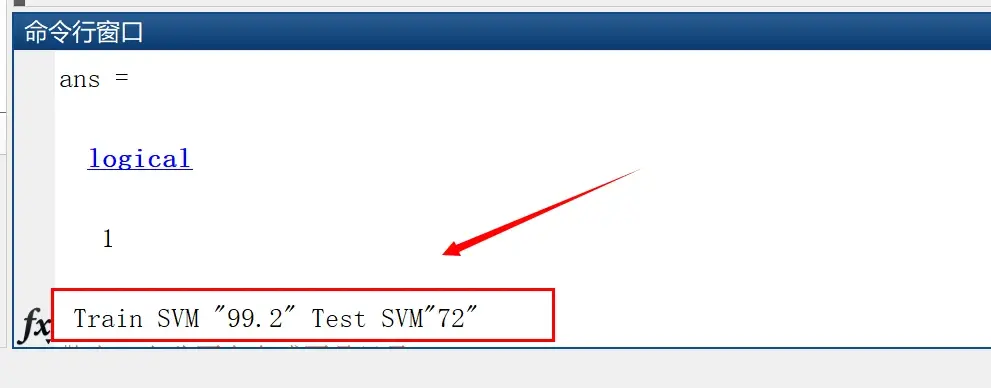
%% KDE % 定义核密度估计的带宽 bandwidth = 0.4; % 您可以根据您的数据调整此值 for i=1:NF % 创建一个核密度估计器 kde = fitdist(original_data(:,i), 'Kernel', 'Bandwidth', bandwidth); % 生成数据点数 num_samples = 1000; % 使用估计的核密度生成合成数据 synthetic_data = random(kde, num_samples, 1); Syn(:,i)=synthetic_data; end %% 用K-means聚类方法获取合成生成数据的标签 [Lbl,C,sumd,D] = kmeans(Syn,Classes,'MaxIter',10000,... 'Display','final','Replicates',10); %% 在二维中绘制原始和生成的数据集 Feature1=1; Feature2=3; f1=meas(:,Feature1); % feature 1 f2=meas(:,Feature2); % feature 2 ff1=Syn(:,Feature1); % feature 1 ff2=Syn(:,Feature2); % feature 2 figure('units','normalized','outerposition',[0 0 1 1]) subplot(4,2,1) plot(meas, 'linewidth',1); title('Original Data');
文章中一些内容引自网络,会注明出处或引用为参考文献,难免有未尽之处,如有不妥,请随时联系删除。
[1]张凡.基于核密度估计和K-L散度的旋转机械故障诊断与健康评估方法研究[D].电子科技大学,2015.DOI:10.7666/d.D662488.
[2]郑勇.基于改良的鲁棒核密度估计的数据驱动不确定集研究及实验仿真[D].重庆大学,2020.
[3]黄杰,尉永清,伊静,等.基于核密度估计的基本概率指派生成方法[J].计算机应用研究, 2020, 37(7):5.DOI:10.19734/j.issn.1001-3695.2018.11.0882.
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文



 155-2731-8020




