软件

产品


数据处理是将FLUENT模拟结果转化为物理信息神经网络(PINNs)所需格式的关键步骤。首先,我们从FLUENT导出流场数据,然后进行数据清洗和格式转换,最终将数据整理为适合PINNs训练和Python处理的数据集。这一过程确保了数据的规范化和准确性,为流体力学问题的高效求解提供了支持。
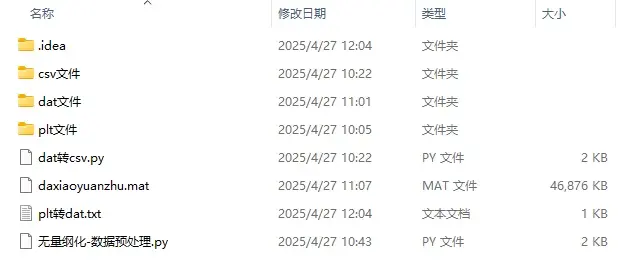
代码可分享,如需代码请私信
CFD-Post里选Volume导出CSV,变量列表里只有Element Values没有Node Values,导出来的坐标是单元中心的,PINNs要的是节点坐标和节点上的物理量,对不上。回去在Fluent里先插值到节点再导,或者CFD-Post的Export对话框里把Location改成Volume,变量选Velocity、Pressure、Temperature,输出格式选CSV,勾上Node Values,坐标列自动带X、Y、Z,路径D:\Fluent_work\export\,文件名带时间步编号。
具体步骤记一下,Fluent算完保存case和data,打开CFD-Post,File→Load Results选dat文件,Variables里勾上需要的量,Location里选Volume,选整个流体域,File→Export→ASCII,格式CSV,分隔符逗号,变量选Velocity、Pressure、Temperature、Turbulence Kinetic Energy,勾Node Values,导出。瞬态的话在Timestep Selector里选一个时间步导一个,或者Export里选All Timesteps,但文件会大得离谱,变量名里的空格在CSV列名里变成Velocity u,Python里用df['Velocity u']读。
Fluent TUI也能导,命令/file/export/ascii,按提示选变量、选面或体、选Node或Cell Center,可以写journal批量跑,服务器上没图形界面就用这个。参数顺序记不清了,大概是这样:/file/export/ascii,文件名,变量列表,位置,节点或单元,然后yes/no。TUI导出节点值需要先在Fluent里把变量插值到节点,默认导出的是单元中心,不设置的话PINNs用不了。
数据量是个问题,整个体导出来几十万到几百万节点,CSV几个GB,PINNs训练用不了这么多。CFD-Post里用Sampling创建Point Cloud或者Plane,在尾流、边界层这些感兴趣的区域采样,或者导出后用Python pandas随机采样10%,按空间均匀采样更好,保留坐标和变量写成新的CSV,采样要覆盖边界和内部,PINNs的损失函数需要内部残差和边界条件。
瞬态数据每个时间步导一个CSV,命名按时间步编号,Python循环读取,给每个文件加一列time,然后concat成大数组,时间列从CFD-Post的Timestep Selector里读,或者从Fluent的dat里读,注意时间步长和物理时间,Fluent里时间步长是秒,CFD-Post里显示的是时间值。导出时选All Timesteps会生成一个文件,每行一个节点一个时间步,数据量爆炸,不如分步导。
单位与归一化,Fluent默认SI,坐标m,速度m/s,压力Pa,温度K,PINNs训练前把坐标和变量归一化到[-1,1]或[0,1],用MinMaxScaler,压力注意表压还是绝压,CFD-Post里Pressure是表压,操作压力不是0的话绝压=表压+操作压力,温度如果是K,归一化时注意范围,密度等变量如果也要,同样导出,归一化参数保存,推理时反归一化。
并行分区,并行计算时Fluent每个分区一个dat,CFD-Post读入自动合并,导出没问题,如果用Fluent直接导出,每个分区一个文件,需要合并,用CFD-Post更省事,TUI的话在Fluent里先切换到串行不现实,还是CFD-Post。导出CSV时变量名有逗号,用制表符分隔,坐标有科学计数法,Python读取没问题,数据缺失某些节点没有值,用NaN,PINNs需要处理,导出时选择Node Values而不是Element Values。
如果CFD-Post没有Node Values选项,在Fluent里用File→Export→Solution Data→ASCII,选择Node,选变量,导出,路径D:\Fluent_work\export\node_data\,那个瞬态导出的Python脚本改成按时间步循环,变量列表从CFD-Post的CSV里自动读取,脚本里时间列是……
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文


 155-2731-8020