Fluent中的Ffowcs Williams-Hawkings (FW-H)模型和Broadband Noise Sources (BNS)模型是两种应用场景和基本原理截然不同的声学工具。
简单来说,它们的根本差异在于:
- FW-H 模型:用于预测声音如何从声源传播出去,并计算在远场某个具体“听众”(接收点)位置的声压级(SPL)和频谱。它是一个声传播模型。
- BNS 模型:用于在流场内部定位宽频噪声的主要产生区域(“声源”在哪里)。它是一个声源诊断模型。
下面我们来详细对比这两个模型的差异。
一、 Ffowcs Williams-Hawkings (FW-H) 模型
1. 基本原理
FW-H模型是著名的Lighthill声学类比理论的推广。它把流体运动产生的声场,等效为在均匀、静止的介质中分布的一系列声源。其核心思想是:
- 在流场中定义一个假想的、可渗透的积分表面 (Integral Surface),这个表面将声源区域(如飞机机翼、风扇叶片)与声传播区域完全包裹起来。
- 通过计算这个表面上的流体物理量(压力、速度波动),模型可以积分计算出这些波动传播到远场指定接收点所产生的声信号。
- 它包含了三种声源项: 单极子声源 (Monopole/Thickness Source):由物体运动时排开流体体积的变化引起。 偶极子声源 (Dipole/Loading Source):由作用在物体表面的非定常压力(力)引起,通常是流动噪声中最主要的部分。 四极子声源 (Quadrupole Source):由流场内部的湍流涡运动(非线性效应)引起,在高速流动中比较重要。
2. 计算要求
- 必须基于瞬态流场计算 (Transient Simulation):FW-H需要随时间变化的流场数据作为输入,因此必须先进行URANS (非稳态雷诺平均)、DES (分离涡模拟) 或 LES (大涡模拟) 计算。稳态RANS的结果无法用于FW-H。
- 需要定义源数据面 (Source Surface):用户必须在CFD计算中指定一个或多个面作为声源数据采集面。
3. 输出结果
- 远场接收点的声学信息:可以得到特定位置的声压级 (Sound Pressure Level, SPL)、声压随时间的变化、频谱图 (Spectrum) 等。
- 可以分辨离散噪声和宽频噪声:由于基于瞬态信号,它可以同时捕捉到由周期性流动(如叶片通过频率)引起的离散/尖锐噪声 (Tonal Noise) 和由湍流引起的宽频噪声 (Broadband Noise)。
4. 主要用途
- 远场噪声预测:预测产品(如飞机、汽车、风扇)在远处产生的噪声大小和频率特性。
- 声学认证与合规性分析:评估噪声是否满足法规标准。
- 降噪方案验证:对比不同设计方案的远场噪声表现。
二、 Broadband Noise Sources (BNS) 模型
1. 基本原理
BNS模型是一类半经验的统计模型。它不直接求解声波的传播,而是利用稳态流场的计算结果来估算宽频噪声源的强度和位置。
- 它基于一系列理论,如Proudman的声功率理论、Lighthill声类比的某种简化形式等。
- 模型利用从稳态RANS (Reynolds-Averaged Navier-Stokes) 计算中得到的湍流参数(如湍动能 k、湍流耗散率 ε)来估算单位体积内产生的声功率 (Acoustic Power)。
- 它本质上是一个后处理工具,告诉你流场中哪些区域的湍流最“活跃”,最有可能成为强烈的宽频噪声源。
2. 计算要求
- 基于稳态流场计算 (Steady-State Simulation):通常只需要一个收敛的RANS计算结果即可。这使得其计算成本极低。
- 无需定义额外表面:它直接在整个计算域或指定区域内进行计算。
3. 输出结果
- 声源位置云图:在流场中以云图的形式展示声功率级 (Acoustic Power Level) 或其他声源相关物理量的分布。
- 无法预测远场声压级:它不能告诉你某个具体接收点的SPL是多少。它只告诉你“噪声是在这里产生的”,而不告诉你“在远处听起来有多响”。
- 只能分析宽频噪声:由于基于统计理论和稳态平均场,它无法捕捉离散噪声。
4. 主要用途
- 快速诊断噪声源:在产品设计的早期阶段,快速识别主要的噪声源区域。
- 降噪目标定位:指导工程师应该在哪个部位进行结构优化或增加吸声材料。
- 简化问题:在用更精确的模型(如LES+FW-H)进行昂贵的计算之前,先用BNS圈定关键的声源区域,从而可以优化网格和计算域,节省计算资源。
三、 核心差异对比表
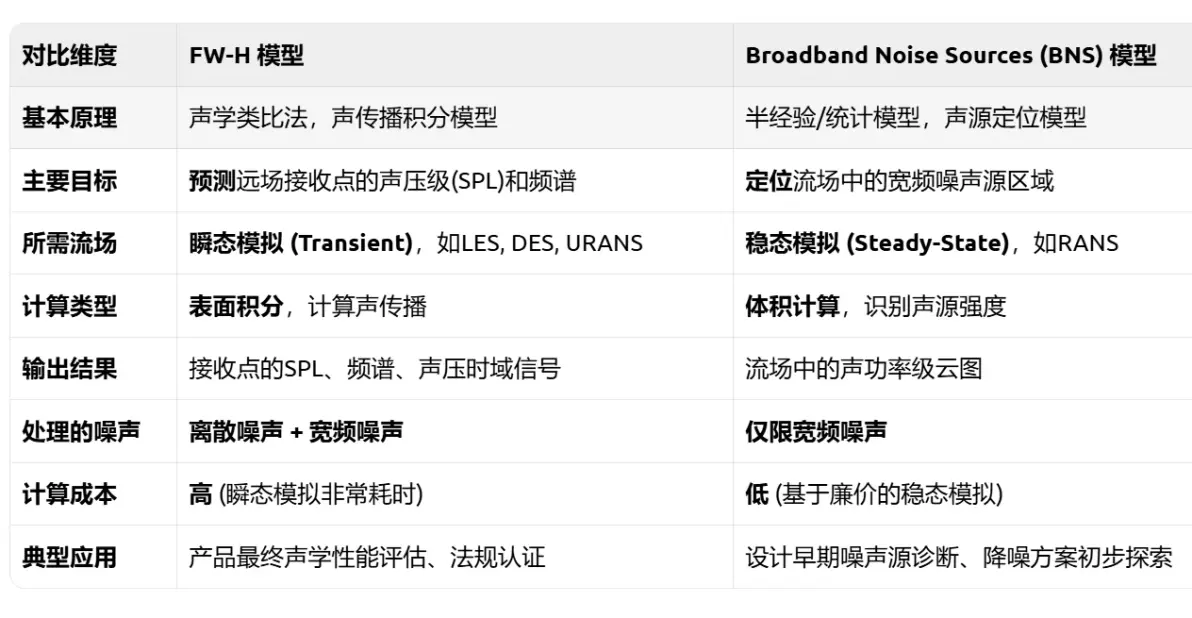
生动的比喻
- FW-H 模型就像是在一个音乐厅外面放置了一个高精度的麦克风。它可以精确录下传到这个位置的声音有多响(SPL)、音调是高是低(频谱)。但前提是,你需要知道舞台上每个乐器(声源表面)是如何振动(瞬态流场数据)的。
- BNS 模型则像是在音乐厅里使用一个热成像仪。你听不到声音,但能清楚地看到哪个乐器或演奏者“发热”最严重(湍流最剧烈),从而判断出谁是噪音的主要贡献者。它快速、直观,但无法告诉你门口的听众感觉声音有多大。
总结与选择建议
在实际工程应用中,这两个模型常常是互补使用的:
- 第一步(快速诊断):先用计算成本低的稳态RANS + BNS模型,快速找出主要的噪声源区域。
- 第二步(精确预测):针对BNS识别出的关键区域,进行网格加密,然后运行计算成本高的瞬态模拟(如LES/DES),最后使用FW-H模型来精确预测远场的声压级和频谱,从而评估降噪措施的效果。
因此,选择哪个模型完全取决于你的分析目的和所处的设计阶段。
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删


 技术文档
 推荐好文


 155-2731-8020