软件

产品


odb打开一半卡死,提示内存不够,几百万单元的模型场输出每步都写,odb文件几十个G,打开都费劲,后处理切片转不动,先从场输出下手,把frequency从1改成每5个增量步或者每0.01秒写一次,稳态分析就改成last increment,没必要每一步都存。
场输出用F-Output,控制的是整个模型的云图数据,频率设置在step模块里field output request,frequency选项有三个,every n increments给个具体数字比如5或者10,evenly spaced time intervals按时间间隔均匀输出,比如总时间1秒给100个点,输出频率跟增量步的实际大小无关,abaqus自己插值,number of intervals给50还是100看需要多少帧动画,多了也没用,人眼能分辨的就那么几帧。
历史输出用H-Output,针对特定节点、单元、参考点,追踪一个或几个变量随时间的变化,比如某个节点的位移、某个单元的应力、某个参考点的反力,频率一般比场输出高,每一步都写也行,数据量小,但要是追踪几百个点每个都每一步写那也扛不住,选点的时候精简,只选关心的位置,别整个set全选上。
输出变量也要控制,默认的场输出把S、U、RF、PE、PEEQ、LE全写上去了,实际分析只用S和U的话把其他关掉,编辑field output request,output variables里选specify,勾需要的,不勾的删掉,变量少一个odb小一圈,特别是PE和PEEQ这种每个积分点都要算的变量,几十万单元的话数据量翻倍。
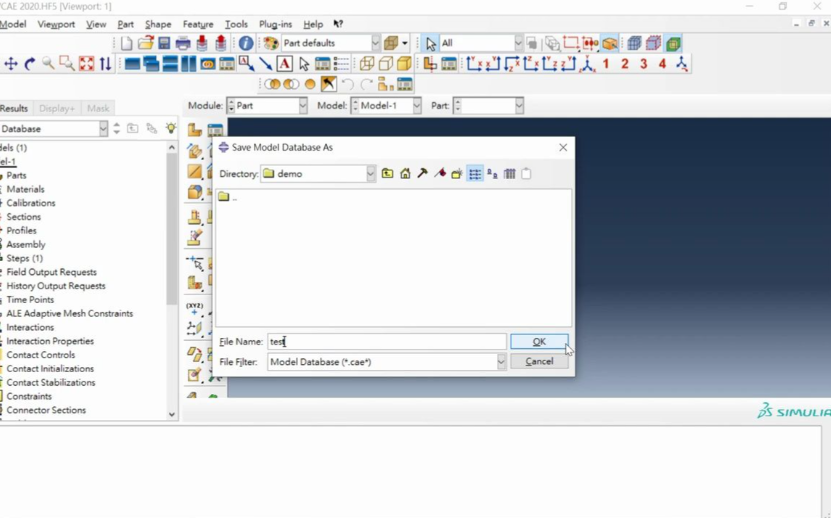
Section point输出是壳和梁的大户,默认所有截面点都写,壳单元有5个截面点,如果只看顶层和底层的应力,section point里选specific,勾首末两个,中间三个不写,数据量直接少一半,实体单元就一个截面点无所谓。
输出到集合,如果只关心某个区域的结果,在field output request里domain选set,建一个set只包含关心的部件或者面,其他区域不输出,odb体积缩得明显,全模型几百万单元,只关心中间一个零件的话,域缩到十分之一数据量也缩到十分之一。
Restart文件也要控,restart request的frequency别跟场输出一样设1,只在需要重启动的增量步写,比如每隔50步写一次,或者指定几个关键增量,restart文件比odb还大,不控的话磁盘直接爆,.res文件写的时候是覆盖还是追加在step里选,append的话所有中间状态都留着,overwrite只留最后一个增量。
后处理读odb慢的另一个原因是odb里存了太多用不到的结果帧,跑完了想删掉一些帧用odbCombine或者abaqus python脚本filter,把前100帧和后100帧留下,中间过渡段删掉,不过删帧也费时间,不如一开始就设好频率,省得跑完了再折腾。
提交前在job模块里看一下估算的文件大小,input file里*Output那部分检查一下,场输出频率、变量列表、域范围三个都看一眼,确认没问题再提交,跑起来之后看sta文件里的增量步数和估计的odb大小,不对了及时kill掉,别等跑了两天才发现odb打不开。工作目录D:\abaqus\output_ctrl\里放几个模板,静力学、显式动力学、瞬态热各一个,下次直接用……
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文


 155-2731-8020