软件

产品


分析名默认就是输出文件的根名,不写扩展名那部分。你在File→Save As里存成`fourbars_sim1`,Adams View读回来的时候就自动建一个叫`fourbars_sim1`的分析。如果一个目录下同时有.res和.req,它只认名字根,两个文件都挂到同一个分析下面。这就是为什么批量跑的时候结果前缀不要用默认的,全叫`last_run`最后分不清哪个是哪个。
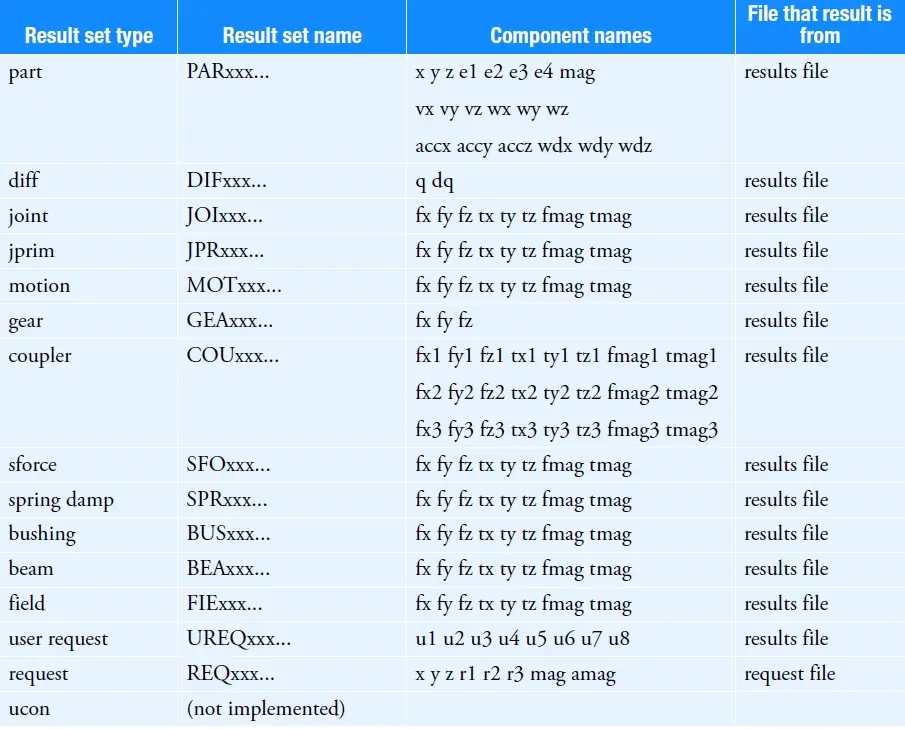
结果集名字的来源跟分析名是两码事。打开`.res`或`.req`文件之后,Adams View按REQ语句的编号或者对象类型自动生成结果集名。`REQUEST/1`对应`REQ1`,一个Part对应`PARxxx`,一个Joint对应`JOIxxx`,`sforce`是`SFOxxx`,bushing是`BUSxxx`,spring-damper是`SPRxxx`,motion是`MOTxxx`,gear是`GEAxxx`,coupler是`COUxxx`,beam是`BEAxxx`,field是`FIExxx`。完整名是`.分析名.结果集名.组件名`,比如`.SHIFT.REQ1.X`,分析名省略的时候直接`REQ1.X`也能引用。
`.res`和`.req`不是一回事。`.res`是求解器自动写的结果文件,包含所有Part、Joint、Force的位移速度力这些标准输出。`.req`是Request定义的自定义输出,专门抓你想看的量,比如某个Marker的加速度或者某个Measure的值。Request的数据默认也会写进`.res`,除非你手动把REQSAVE关掉。所以有时候`.req`里的曲线在`.res`里也能找到,就是结果集名不一样,`.req`里叫`REQ1`,`.res`里可能归到`PAR`或者`JOI`下面去了。
`.res`文件本质是XML,能用Notepad直接打开看,前面一大段是MSC的版本信息和用户名,跳过到`Analysis`标签里面,`stepmap`段存的就是结果名称和步数映射,再往下才是数值数据。`.req`也是文本格式,结构比`.res`简单,就是请求名加数据列。两个文件都能用Python的ElementTree解析,`pre_defined_name.xlsx`里写要提取的结果名,跑完脚本生成`data_output.xlsx`。
改名字最直接的地方在Template Builder里,Build→Request→Modify,弹窗里能改Results Set Name和Component Name。但是bushing request的特殊性在于它属于UDE,每次打开模板的时候UDE重新实例化,改的名字会被模板更新宏覆盖掉。要么写个宏在模型打开之后再循环改名,要么自己建UDE,要么用`acar template_builder request_names modify`在自动化脚本里改。
多工况跑的时候有个坑,几个Request用了同一个结果集名,后处理里那个结果集就跑到容器外面去了,不在testrig下面挂着,找不着。避免的办法是每个Request给独立的结果集名,或者用`output_prefix`在RELOAD之后换输出前缀,`.req` `.res` `.gra`全部换一套新名字。设计研究、DOE和优化跑之前一定先把前缀设好,跑完几十个工况结果文件全堆在一个目录里,靠文件根名区分工况,前缀不设的话全叫`last_run`,打开全是同一个分析。
`.nam`文件在Insight跑DOE的时候生成,把Request名字映射到ID号,只有这一个用途。单个跑的`.nam`直接拷过来改成跟Insight输出同名的,DOE的`.nam`就能复用,不用重新生成。XML格式的输出已经自带名字和组件信息了,`.nam`在那种情况下就是多余的。
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文


 155-2731-8020