软件

产品


项目节点前一周,仿真组十几个人同时提交 ANSYS 或 ABAQUS 任务。有人等了四个小时还没排上,项目经理直接打电话过来问"为什么买了这么多许可还不够用"。
第一反应往往是加许可。但很多时候问题根本不在这。
仿真任务从提交到出结果,要过两道关:许可签出(check-out)和计算资源分配。很多人把这两件事混在一起说"排队",其实完全是两个问题。
采购说"买了 30 套",IT 说"峰值才 20",业务说"根本不够用"。三个人说的不是同一个东西。
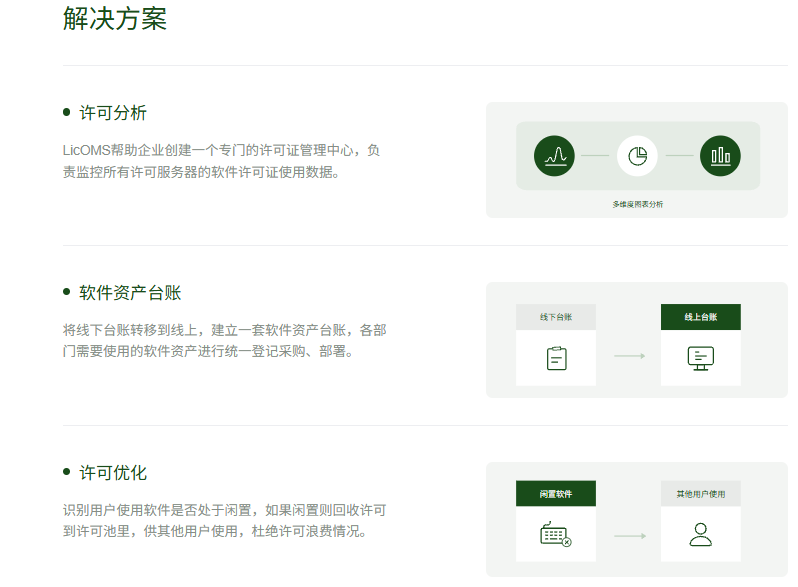
第一步:分开识别许可等待和算力等待。 查 FlexNet 或 DSLS 日志,确认拒绝发生在哪一层。能定位到具体设备、账号、模块,光看汇总数没用。
第二步:统计任务提交、启动、完成时间。 把当前状态和历史变化分开记。今天的数据解释不了上周的事。
第三步:识别失败重试和重复任务。 有人任务失败了不查原因,直接重提,同一个计算占了两套许可。这类无效占用在日志里一抓一个准。
跨部门评审只用同一份底稿,IT、采购、业务对着同一张表说话,少扯皮。
先建队列分级。 紧急任务和普通任务分开排队。项目节点前的关键仿真走优先队列,日常验证走普通队列。从可控的部门试点,别一上来全公司推。
再做错峰。 可延迟的任务安排在夜间或周末跑。HPC 调度器(PBS / Slurm)都能配时间窗口,把普通流程和非紧急流程分开,减少临时口头授权。
限制无效重试。 任务失败后自动进入冷却期,不能无限制重提。执行前通知受影响用户,执行后收集反馈。
结合项目计划做容量预测。 业务排期提前给 IT,节点前两周就知道许可和算力够不够。保留规则版本和变更理由,后面审计用得上。
别只看一个总数,这几个要连续看:
某汽车零部件企业,仿真组 15 人,ABAQUS 许可 20 套。每次项目节点前都抱怨排队严重,IT 查日志发现峰值并发只有 14 套,许可明明够用。
进一步看任务日志:有 4 个人习惯任务一提交就盯着,等两分钟没启动就取消重提,同一个任务反复占坑;还有 3 个夜间批处理任务被手动提到白天跑,和在线用户抢许可;另外有 2 套许可被离职员工的账号绑定着,一直没释放。
整改就三件事:配了任务失败后 10 分钟冷却期,夜间批处理强制走非高峰队列,回收了离职账号的许可绑定。没多花一分钱,节点前的排队时长从平均 3 小时降到 40 分钟。后来某个大项目确实冲到了 19 套并发,那时候才补了 3 套临时许可。
问题从来不是"少几套",而是"怎么在排"。
 技术文档
 推荐好文


 155-2731-8020