软件

产品


20核跑得好好的一台工作站,加到60核之后单步时间从0.8秒涨到1.4秒,残差曲线倒是没炸,就是慢,慢得让人想砸键盘。D:\Fluent_work\parallel_test\60core_slow.log里记着这个对比数据。
先看每核摊到多少网格。算例网格量120万,20核的时候每核6万,60核的时候每核2万。Fluent的并行效率有个经验阈值,每核10万网格以上效率能维持在80%以上,低于5万就开始明显掉,掉到2万的时候核大部分时间在等MPI同步,真正算方程的时间占比很小。论坛上有人总结过,50k节点每核以下基本给不了什么加速,20k以下纯属浪费资源。120万网格的理论高效上限大概12核,给到20核已经开始打折,给到60核纯粹是跟自己过不去。查一下自己算例的网格数除以核心数,低于5万就把核心数降回来。D:\Fluent_work\parallel_test\cell_per_core.txt里算了几组,60核的时候每核2万,20核的时候6万,差距就在这里。
超线程是第二个坑。60核的机器如果是30物理核开超线程,操作系统认出来的60个逻辑核实际上是30个物理核在硬扛,两个线程抢一个物理核的执行单元,Fluent这种CPU密集的浮点运算在超线程下效率不升反降。任务管理器里看CPU利用率,60核跑起来如果利用率只有50%到60%,说明逻辑核在互相等,把核心数设成物理核数,30核或者28核,单步时间可能比60核还短。论坛上有人8核16线程的机器,填16核跑出来比填8核还慢,填20核也能算但利用率只有一半。BIOS里关超线程最彻底,不想动BIOS就在Fluent启动的时候把核心数设成物理核数,留一两个核给操作系统。
Hwloc错误导致MPI没法把进程绑到唯一的物理核上,多个进程挤在同一个核上打架。症状是核心数设了60但CPU利用率忽高忽低,或者只有少数几个核在跑满,其他核闲着。Fluent启动的时候加`-affinity=1`(Windows)或者`-affinity=core`(Linux),强行把每个计算进程分配给一个专用物理核。用Intel MPI的话它自带绑定机制,不用手动加affinity,但如果是Platform MPI就得显式打开。D:\Fluent_work\parallel_test\launch_args.txt里记着几种启动参数的写法,`-t60 -affinity=1 -mpi=intel`这一串。
MPI版本也有影响。Fluent默认在小规模本地并行(小于64逻辑核)用Intel MPI,2021版的Intel MPI跟2018比在某些算例上内存占用涨了,solver性能有变化。如果60核正好卡在默认MPI的某个性能拐点上,试试`-mpi=intel2018`回退到旧版,或者设环境变量`USE_INTEL_MPI_2018=1`。反过来的情况也有,超过64核的时候Fluent默认切到另一个MPI实现,60核刚好在切换边界附近,行为可能不稳定。命令行里显式指定MPI版本比让Fluent自己选稳。
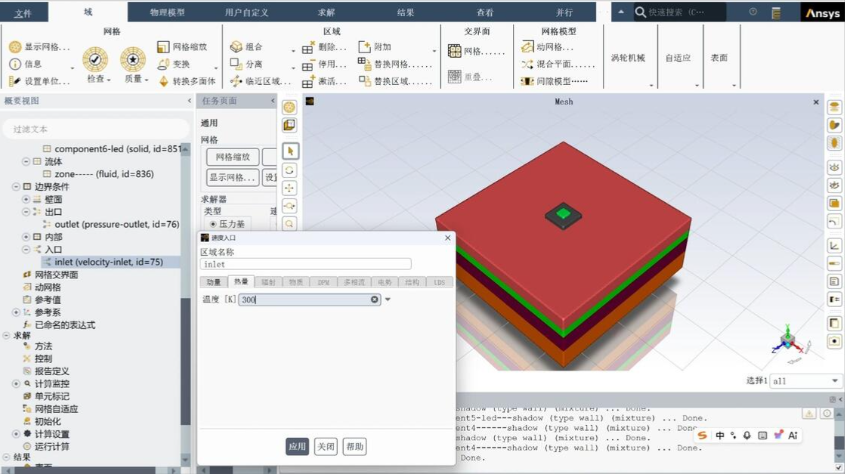
内存带宽和NUMA是另一个层面的事。60核如果跨了多个NUMA节点,每个NUMA有自己的内存控制器,跨节点的内存访问延迟比本地高一个量级。Fluent的AMG求解器对内存带宽很敏感,跨NUMA的访问把带宽吃掉了,核多了但每个核能拿到的带宽反而少了。服务器上检查一下NUMA拓扑,`numactl --hardware`或者Windows的任务管理器里看NUMA节点分布。如果60核跨了四个NUMA节点,把核心数限制在一个NUMA节点内,或者用`--ntasks-per-node`控制每个节点的进程数。D:\Fluent_work\parallel_test\numa_topology.txt里记了这台工作站的NUMA配置。
求解器设置也影响并行效率。压力基耦合求解器(Coupled)的AMG算法在分区变小的时候并行效率掉得比分离式快。如果60核跑的是Coupled加AMG,换回SIMPLE加分离式,每核的通信量小很多,60核的效率可能反而比20核高。残差收敛慢一点但总时间短。Pseudo Transient也是同理,伪时间步的并行扩展性比稳态迭代差。D:\Fluent_work\parallel_test\solver_comparison.txt里对比了几组,60核用Coupled的时候单步1.4秒,换SIMPLE降到0.9秒,20核用Coupled是0.8秒,60核的SIMPLE跟20核的Coupled差不多。
最后测一下并行效率,Fluent的Parallel→Network→Show Latency,看看节点间通信延迟和带宽。单机本地并行的延迟应该在微秒量级,超过10微秒说明MPI绑定有问题或者内存带宽被吃满了。再算一下加速比,20核单步0.8秒,60核单步1.4秒,加速比0.57,负加速。把核心数降到20到24之间,每核网格5万到6万,加速比回到1以上再往上试。D:\Fluent_work\parallel_test\scaling_curve.xlsx里画了一条曲线,横轴核心数,纵轴加速比,20核之后开始往下掉,60核掉到0.6以下。下次把超线程关了,用`-affinity=1`重新跑一遍60核,看单步时间能不能压到0.6秒以内,那个affinity参数的写法是……
免责声明:本文系网络转载或改编,未找到原创作者,版权归原作者所有。如涉及版权,请联系删
 技术文档
 推荐好文


 155-2731-8020